

课程介绍
准备简短的口播片段来介绍课程。保持内容聚焦,并结合学习材料进行审阅。
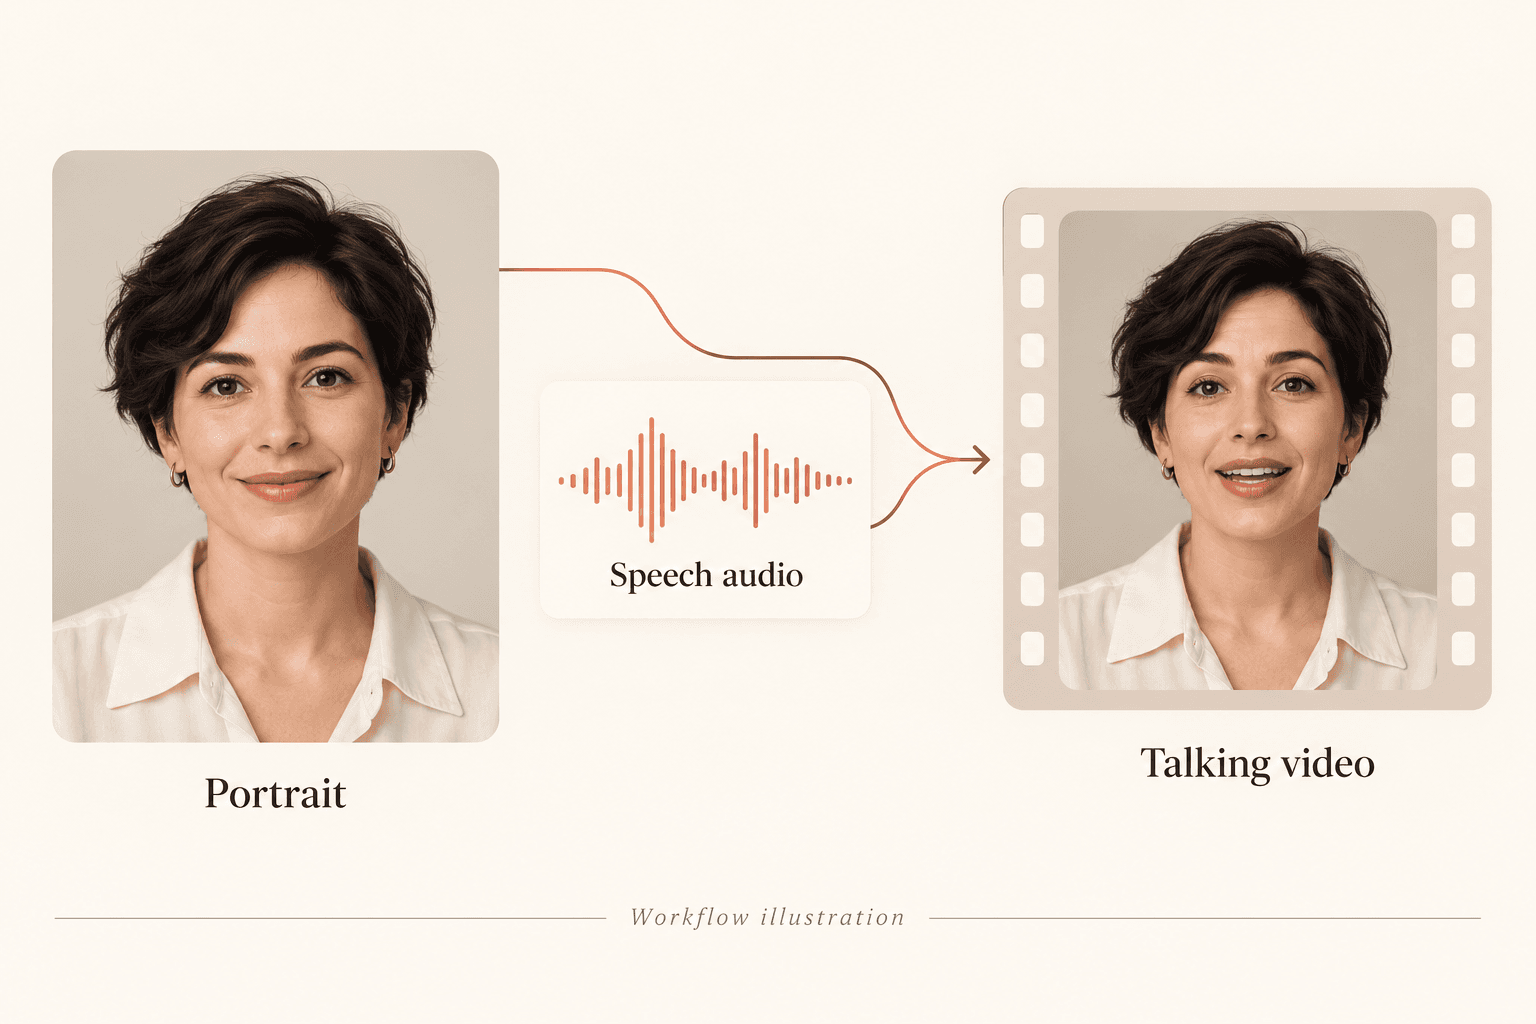
使用面部无遮挡的清晰单人肖像。使用可识别人物前,请先获得必要许可。
使用合适的语音录音,或采用单独的语音生成工作流程。在用其驱动人像前,请检查发音、语速和音频质量。
选择兼容的口播虚拟人模型,并通过其当前的输入控件提供人像和音频。运行前请检查其限制和积分要求。
观看并聆听结果。检查嘴部动作、面部细节、时间衔接和不需要的动作;必要时修改输入或请求重新生成。
准备简短的口播片段来介绍课程。保持内容聚焦,并结合学习材料进行审阅。
使用已获许可的出镜者人像和已批准的语音来探索介绍内容。发布前,请审阅所有产品或品牌相关声明。
将已批准的人像作为后续请求的参考。比较每个新成片;相同输入并不保证外观或动作完全一致。
| 输入 | 一张人像和语音音频,具体取决于所选虚拟人模型的要求。 | |
|---|---|---|
| 输出 | 一段生成的口播视频,需要进行视觉和音频审阅。 | |
| 运行位置 | 原生 Astorie 画布;本页面不能替代模型输入控件。 | |
| 模型差异 | 支持的格式、时长、语言处理和费用各不相同。生成前请阅读当前启用模型的详细信息。 | |
| 身份与声音 | 仅使用您有权使用的素材。声音克隆并非此工作流程的必需步骤。 |
不是。人像是静态图像。口播虚拟人请求还会在兼容的画布工作流程中使用语音音频来生成视频。
请使用您有权使用的录音,且其格式须被所选模型接受。生成前请查看当前输入要求并审阅录音。
不保证完全匹配。请检查生成视频片段中的唇形同步、面部细节、表情和时间衔接。
这些限制取决于所选模型和设置。请查看当前模型详细信息,而不要假定每个虚拟人请求都有固定的输出。