

Lektionseinführungen
Bereiten Sie einen kurzen Talking-Head-Abschnitt zur Einführung in eine Lektion vor. Halten Sie die Sprache fokussiert und prüfen Sie sie neben dem Lernmaterial.
Astorie-Canvas-Workflow
Bringen Sie ein Porträt und Sprachaudio zu einem kompatiblen Avatar-Modell auf der Canvas. Wählen Sie das Modell, prüfen Sie seine Eingaben und begutachten Sie den resultierenden Clip. Die Illustration zeigt den Workflow; sie ist keine Wiedergabe-Demo.
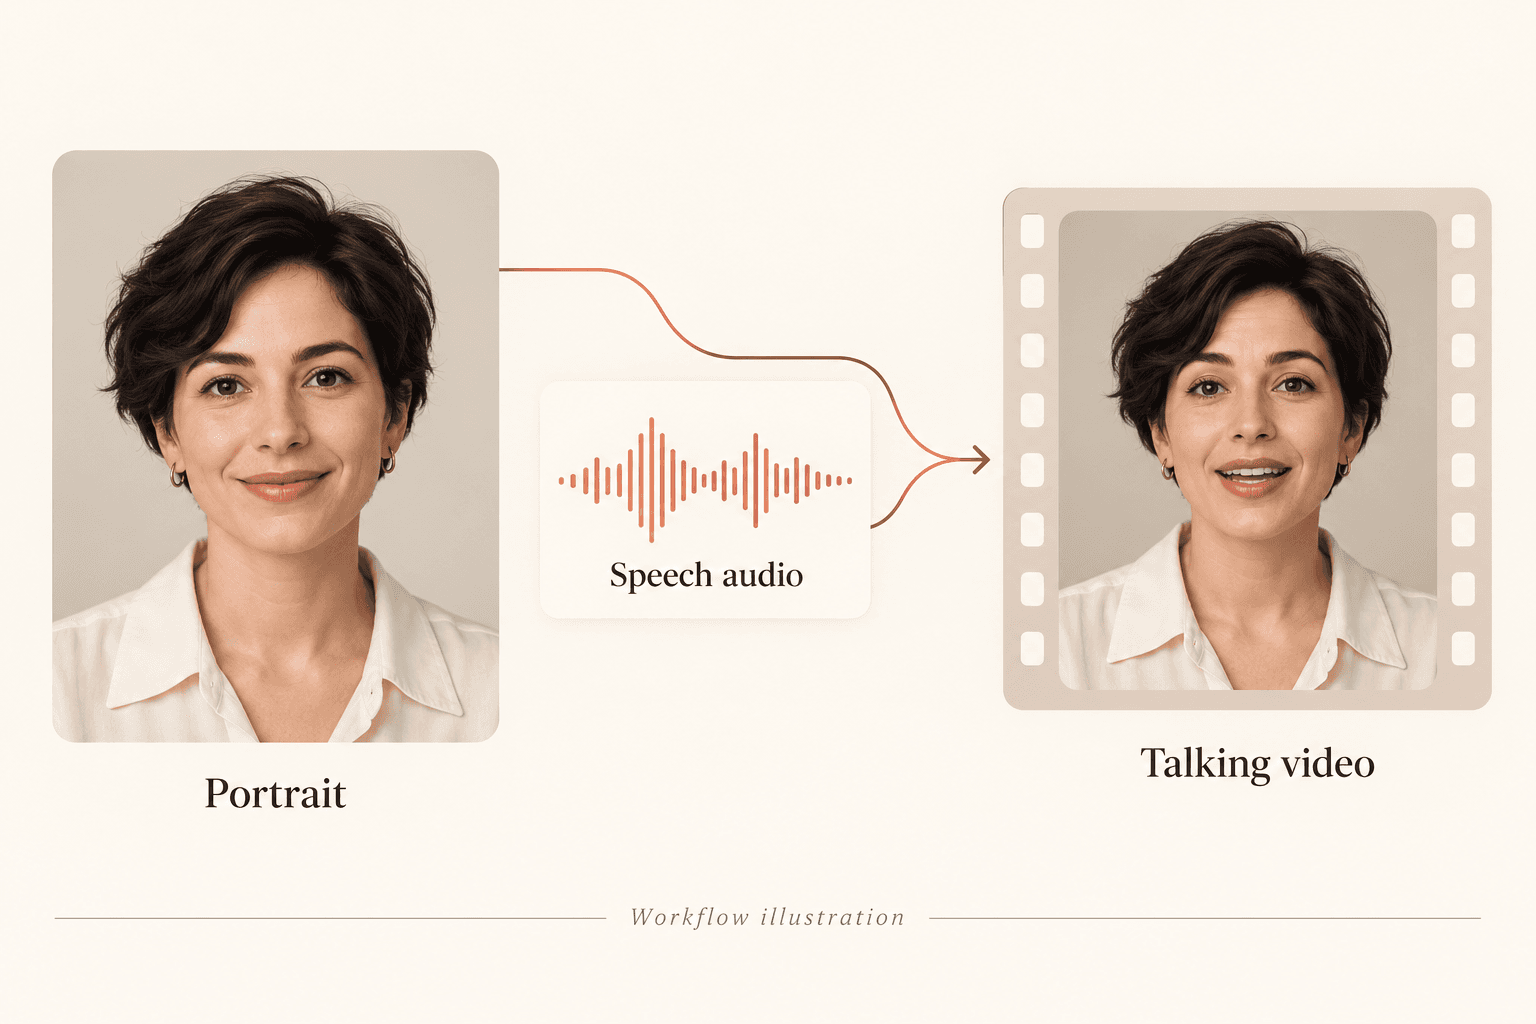
Verwenden Sie ein klares Porträt einer einzelnen Person mit unbedecktem Gesicht. Holen Sie die erforderliche Erlaubnis ein, bevor Sie eine erkennbare Person verwenden.
Verwenden Sie eine geeignete Sprachaufnahme oder einen separaten Workflow zur Sprachgenerierung. Prüfen Sie Aussprache, Tempo und Audioqualität, bevor Sie damit das Porträt animieren.
Wählen Sie ein kompatibles Talking-Avatar-Modell und stellen Sie das Porträt und Audio über die aktuellen Eingabesteuerungen bereit. Prüfen Sie vor dem Ausführen die Limits und den Creditbedarf.
Sehen und hören Sie sich das Ergebnis an. Prüfen Sie Mundbewegungen, Gesichtsdetails, Timing und unerwünschte Bewegungen; überarbeiten Sie die Eingaben oder fordern Sie bei Bedarf eine weitere Aufnahme an.
Bereiten Sie einen kurzen Talking-Head-Abschnitt zur Einführung in eine Lektion vor. Halten Sie die Sprache fokussiert und prüfen Sie sie neben dem Lernmaterial.
Verwenden Sie ein zulässiges Präsentatorporträt und freigegebene Sprache, um eine Einführung zu entwickeln. Prüfen Sie vor der Veröffentlichung alle Produkt- oder Markenbehauptungen.
Verwenden Sie ein freigegebenes Porträt als Referenz für spätere Anfragen erneut. Vergleichen Sie jede neue Aufnahme; dieselbe Eingabe garantiert kein identisches Erscheinungsbild oder identische Bewegungen.
| Eingabe | Ein Porträt und Sprachaudio, abhängig von den Anforderungen des gewählten Avatar-Modells. | |
|---|---|---|
| Ausgabe | Ein generiertes Talking-Head-Video, das visuell und akustisch geprüft werden muss. | |
| Ausführungsort | Die native Astorie-Canvas; diese Seite ersetzt nicht die Eingabesteuerungen des Modells. | |
| Modellunterschiede | Unterstützte Formate, Dauer, Sprachverarbeitung und Kosten variieren. Lesen Sie vor der Generierung die Details des aktiven Modells. | |
| Identität und Stimme | Verwenden Sie Material, für dessen Nutzung Sie eine Erlaubnis haben. Stimmklonen ist kein erforderlicher Schritt in diesem Workflow. |
Nein. Ein Porträt ist ein Standbild. Eine Talking-Avatar-Anfrage verwendet zusätzlich Sprachaudio in einem kompatiblen Canvas-Workflow, um ein Video zu generieren.
Verwenden Sie eine Aufnahme, für deren Nutzung Sie eine Erlaubnis haben und deren Format vom gewählten Modell akzeptiert wird. Prüfen Sie die aktuellen Eingabeanforderungen und die Aufnahme vor der Generierung.
Es gibt keine Garantie für eine exakte Übereinstimmung. Prüfen Sie Lippensynchronität, Gesichtsdetails, Ausdruck und Timing im gesamten generierten Clip.
Diese Grenzen hängen vom ausgewählten Modell und den Einstellungen ab. Prüfen Sie die aktuellen Modelldetails, statt für jede Avatar-Anfrage von einer festen Ausgabe auszugehen.
Bringen Sie ein klares Porträt und geprüftes Sprachaudio auf die Canvas.