

Introductions de leçons
Préparez une courte séquence de tête parlante pour introduire une leçon. Gardez un discours ciblé et vérifiez-le à côté du matériel pédagogique.
Workflow du canevas Astorie
Ajoutez un portrait et un fichier audio de parole à un modèle d’avatar compatible sur le canevas. Choisissez le modèle, examinez ses entrées et vérifiez la vidéo obtenue. L’illustration montre le workflow ; il ne s’agit pas d’une démo de lecture.
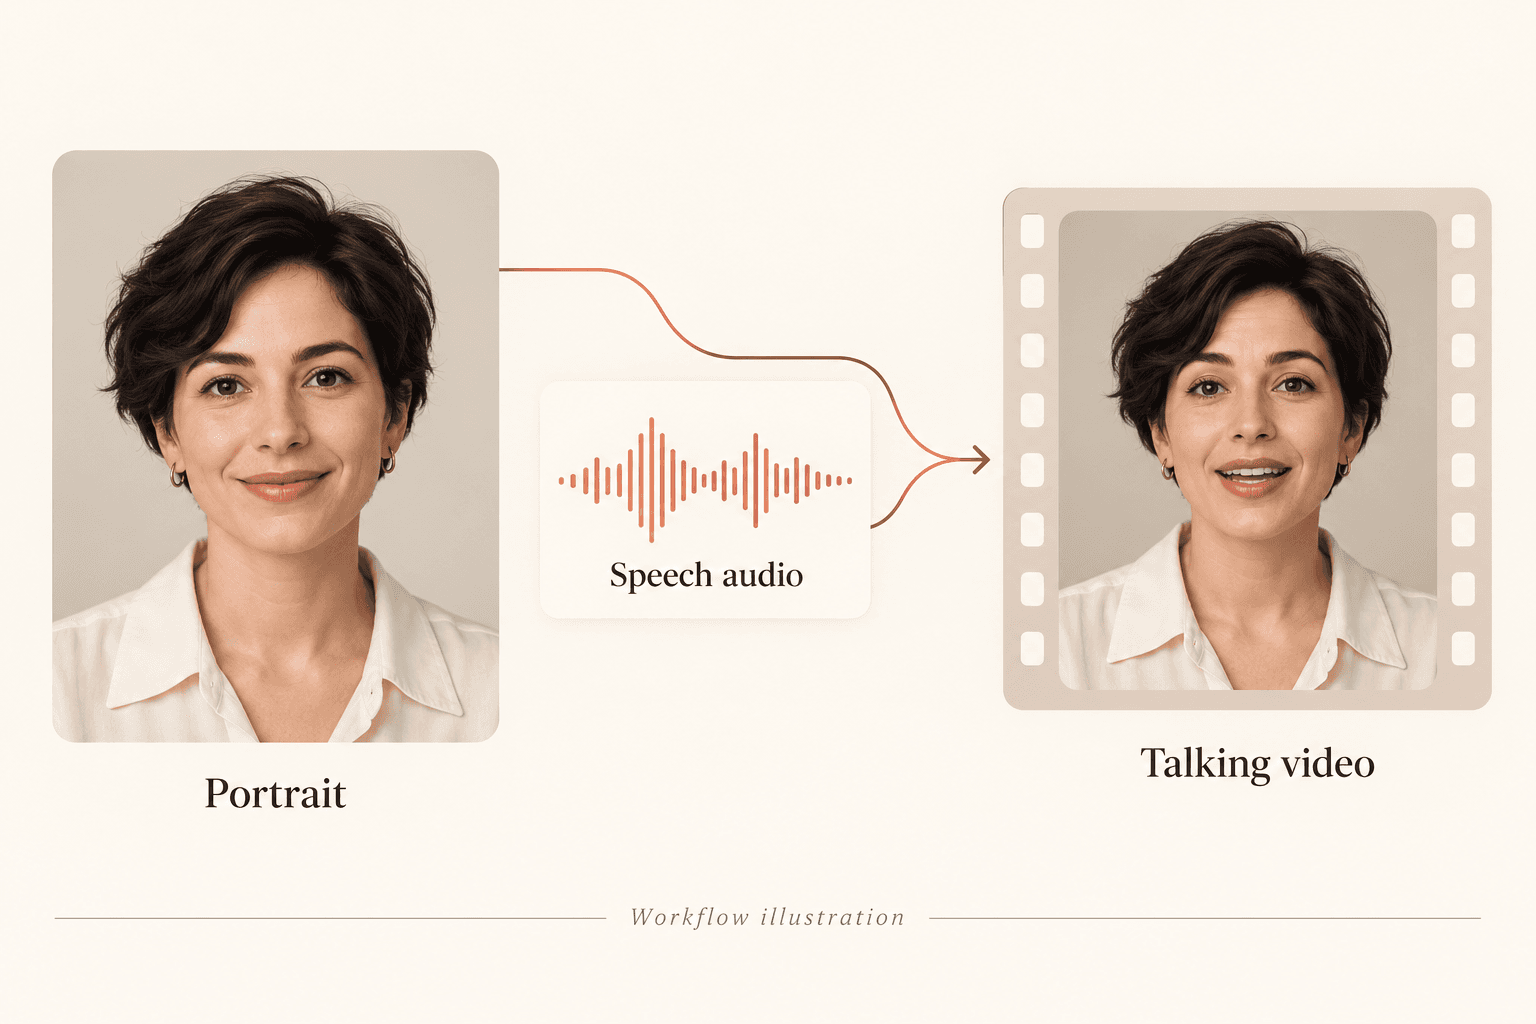
Utilisez un portrait net d’une seule personne, avec le visage dégagé. Obtenez l’autorisation nécessaire avant d’utiliser une personne reconnaissable.
Utilisez un enregistrement vocal approprié ou un workflow distinct de génération de parole. Vérifiez la prononciation, le rythme et la qualité audio avant de l’utiliser pour animer le portrait.
Choisissez un modèle d’avatar parlant compatible et fournissez le portrait et l’audio à l’aide de ses contrôles d’entrée actuels. Vérifiez ses limites et le nombre de crédits requis avant de lancer la génération.
Regardez et écoutez le résultat. Vérifiez les mouvements de la bouche, les détails du visage, le timing et les mouvements indésirables ; modifiez l’entrée ou demandez une autre prise si nécessaire.
Préparez une courte séquence de tête parlante pour introduire une leçon. Gardez un discours ciblé et vérifiez-le à côté du matériel pédagogique.
Utilisez un portrait de présentateur autorisé et une parole approuvée pour explorer une introduction. Vérifiez toute affirmation concernant un produit ou une marque avant diffusion.
Réutilisez un portrait approuvé comme référence pour des demandes ultérieures. Comparez chaque nouvelle prise ; la même entrée ne garantit pas une apparence ou des mouvements identiques.
| Entrée | Un portrait et un fichier audio de parole, sous réserve des exigences du modèle d’avatar choisi. | |
|---|---|---|
| Sortie | Une vidéo de tête parlante générée nécessitant une vérification visuelle et audio. | |
| Où cela s’exécute | Le canevas natif d’Astorie ; cette page ne remplace pas les contrôles d’entrée du modèle. | |
| Différences entre les modèles | Les formats pris en charge, la durée, la gestion des langues et les coûts varient. Lisez les détails du modèle actif avant de générer. | |
| Identité et voix | Utilisez du contenu pour lequel vous disposez d’une autorisation. Le clonage vocal n’est pas une étape obligatoire de ce workflow. |
Non. Un portrait est une image fixe. Une demande d’avatar parlant utilise également un fichier audio de parole dans un workflow de canevas compatible afin de générer une vidéo.
Utilisez un enregistrement que vous êtes autorisé à utiliser, dans un format accepté par le modèle choisi. Vérifiez les exigences d’entrée actuelles et l’enregistrement avant la génération.
Aucune garantie de correspondance exacte ne s’applique. Vérifiez la synchronisation labiale, les détails du visage, l’expression et le timing tout au long de la vidéo générée.
Ces limites dépendent du modèle et des paramètres sélectionnés. Consultez les détails actuels du modèle au lieu de supposer une sortie fixe pour chaque demande d’avatar.
Ajoutez un portrait net et un fichier audio de parole vérifié au canevas.