

課程介紹
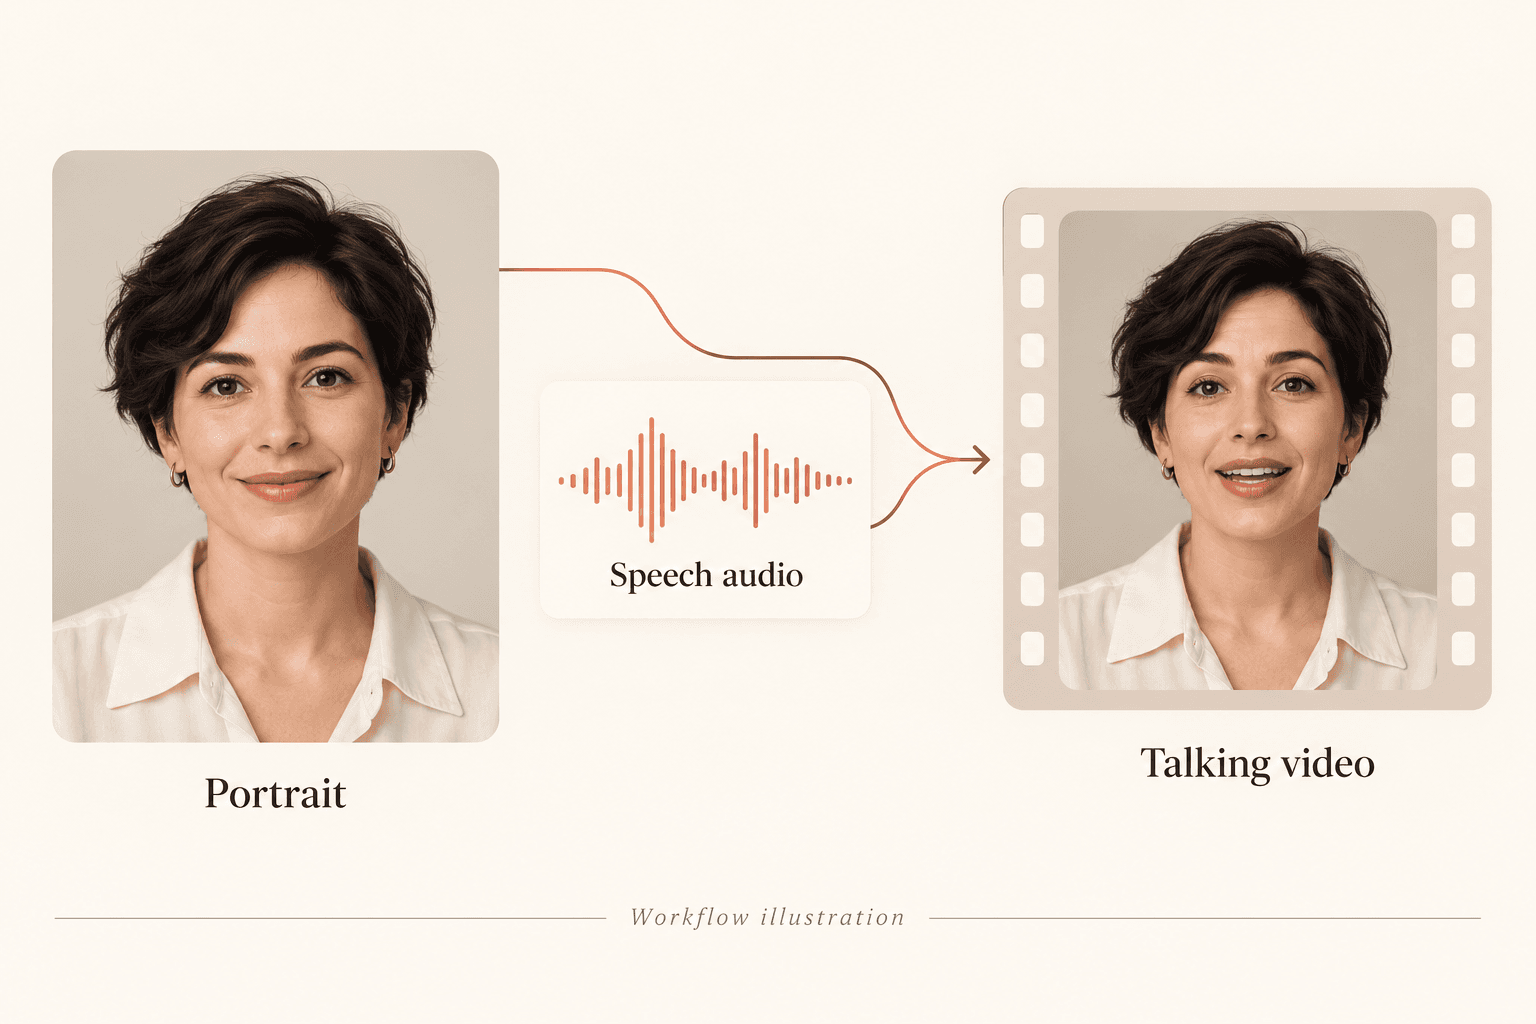
準備一段簡短的說話頭像片段來介紹課程。讓語音內容聚焦,並在教材旁一併檢查。
使用臉部清晰且未受遮擋的單人肖像。使用可辨識的人物前,請先取得必要許可。
使用合適的語音錄音,或採用另一個語音生成工作流程。在用其驅動肖像前,檢查發音、語速與音訊品質。
選擇相容的說話虛擬人像模型,並透過其目前的輸入控制項提供肖像與音訊。執行前請確認其限制與點數需求。
觀看並聆聽結果。檢查嘴部動作、臉部細節、時間同步與不必要的動作;視需要修改輸入內容或要求另一個版本。
準備一段簡短的說話頭像片段來介紹課程。讓語音內容聚焦,並在教材旁一併檢查。
使用已獲許可的呈現者肖像與經核准的語音來探索介紹方式。發布前請檢查任何產品或品牌聲明。
將已核准的肖像作為日後請求的參考重複使用。比較每個新版本;相同的輸入並不保證外觀或動作完全相同。
| 輸入 | 肖像與語音音訊,須符合所選虛擬人像模型的要求。 | |
|---|---|---|
| 輸出 | 需要進行視覺與音訊檢查的生成說話頭像影片。 | |
| 執行位置 | 原生 Astorie 畫布;此頁面不能取代模型輸入控制項。 | |
| 模型差異 | 支援的格式、時長、語言處理方式與費用各不相同。生成前請閱讀目前啟用模型的詳細資訊。 | |
| 身分與聲音 | 請使用您獲准使用的素材。此工作流程不要求進行聲音複製。 |
不是。肖像是靜態圖片。說話虛擬人像請求還會在相容的畫布工作流程中使用語音音訊來生成影片。
請使用您獲准使用、且格式為所選模型所接受的錄音。生成前請確認目前的輸入要求並檢查錄音。
不保證完全一致。請檢查生成影片片段中的唇形同步、臉部細節、表情與時間同步。
這些限制取決於所選模型與設定。請查看目前的模型詳細資訊,不要假設每個虛擬人像請求都會有固定的輸出結果。