
ByteDance
OmniHuman
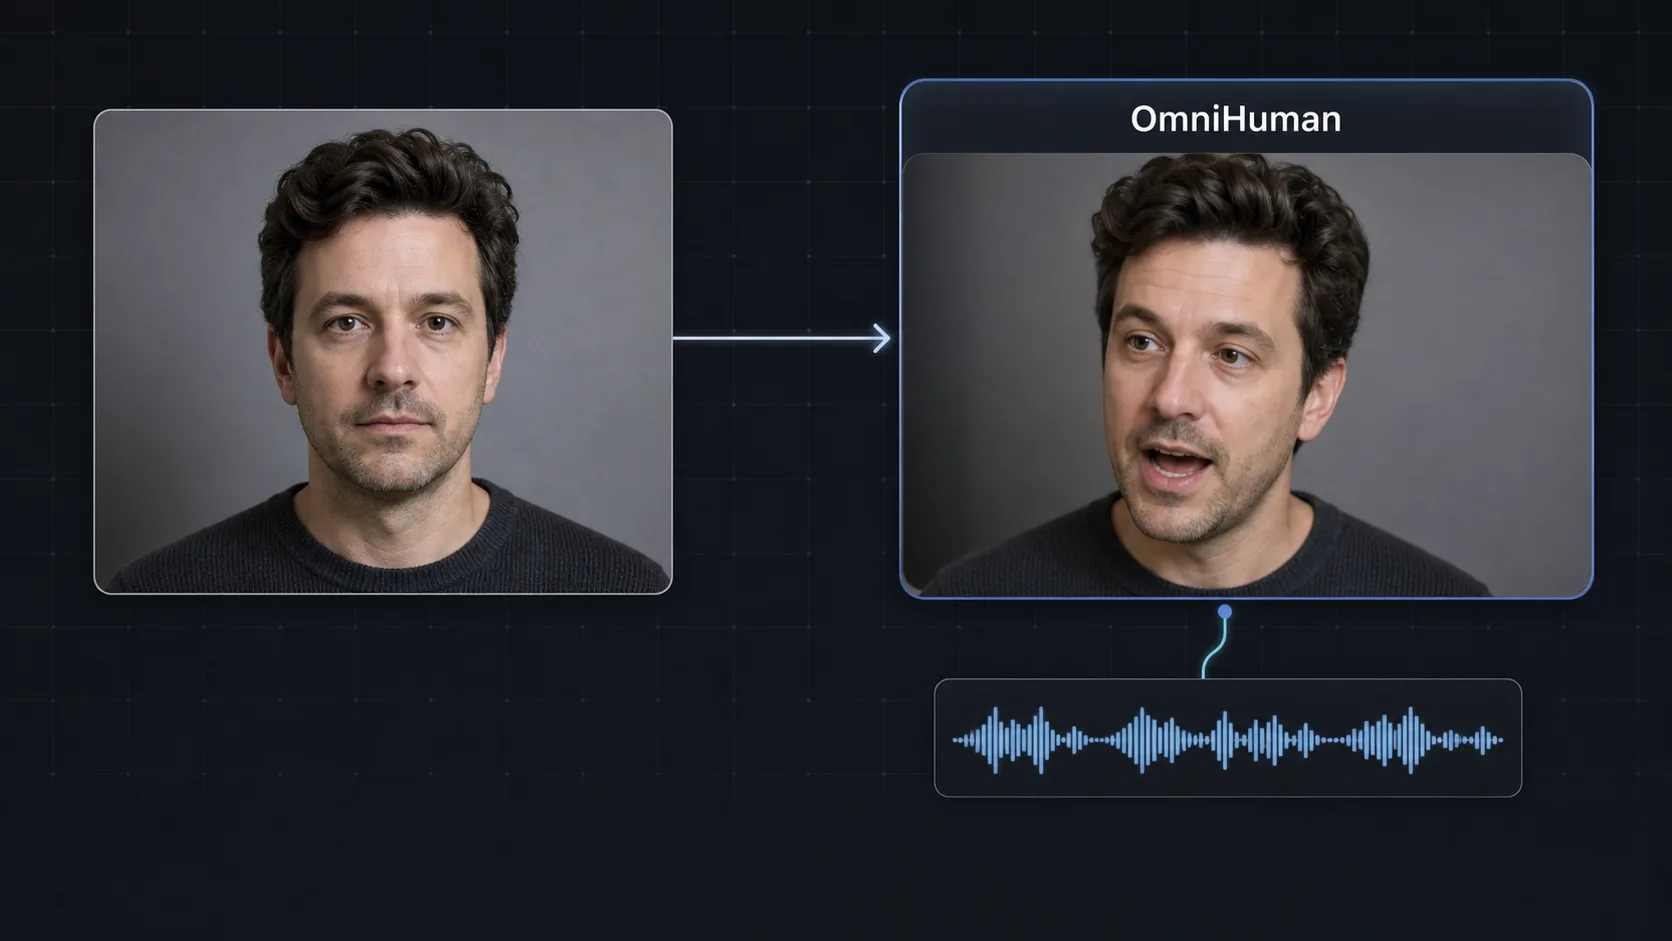
OmniHuman은 ByteDance의 오디오 기반 립싱크 모델입니다. 정지된 인물 사진 한 장과 오디오 트랙을 입력하면 프레임 단위로 정확한 입 모양, 표정, 자연스러운 고갯짓까지 담은 말하는 얼굴 영상을 만들어줍니다. ByteDance Intelligent Creation이 개발한 OmniHuman AI 패밀리(v1, v1.5)는 2026년 기준 Astorie에서 이용할 수 있는 가장 정교한 립싱크 비디오 모델 중 하나입니다.
OmniHuman은 ByteDance의 오디오 기반 인물 사진 애니메이션 모델로, 사진 한 장과 음성 트랙을 립싱크된 말하는 얼굴 영상으로 변환합니다. ByteDance OmniHuman은 퍼포먼스 전체를 처리합니다. 오디오 파형을 읽어 동기화된 입 모양, 눈 깜빡임, 미세 표정, 고갯짓까지 만들어내기 때문에 인물이 실제로 주어진 말을 하고 있는 것처럼 보입니다. 1.0 버전은 정면 사진과 음성을 결합해 안정적인 OmniHuman 립싱크와 고개 움직임을 만들어냅니다. 1.5 버전(OmniHuman-1.5)은 립싱크 정확도를 한층 높이고 일러스트나 스타일화된 얼굴을 포함한 더 다양한 인물 스타일을 지원하며, 더 자연스러운 고갯짓과 더 길고 안정적인 결과물을 만들어냅니다. Astorie에서는 두 버전 모두 텍스트-투-스피치 모델과 동일한 노드 기반 캔버스 위에 있어서, 브라우저를 벗어나지 않고 텍스트 → 음성 → OmniHuman 애니메이션까지 한 번에 처리할 수 있습니다. Kling AI Avatar나 HeyGen류의 아바타 도구와 비교하면, OmniHuman은 고정된 아바타 라이브러리 대신 한 장의 이미지에서 순수한 립싱크 완성도를 뽑아내도록 설계되어 있어, 어떤 얼굴이든 말하게 만들어야 할 때 가장 먼저 찾게 되는 선택지입니다. 팬아웃 기능을 사용하면 같은 오디오를 OmniHuman, Kling AI Avatar, Hailuo Speech-02에 동시에 연결하고 버전 트레이에서 가장 좋은 결과물만 남길 수 있습니다.
OmniHuman Variants
| Variant | Description |
|---|---|
| OmniHuman v1 | 립싱크, 표정, 고갯짓까지 구현하는 오디오 기반 인물 사진 애니메이션입니다. |
| OmniHuman v1.5 | 립싱크 정확도를 개선하고 다양한 인물 스타일을 더 잘 지원합니다. |
Capabilities
Supported Aspect Ratios
Best For
- 말하는 얼굴 영상과 가상 발표자
- 어떤 인물 사진이든 보이스오버나 노래에 맞춰 립싱크
- 팟캐스트와 내레이션 시각화
- 콘텐츠 크리에이터 아바타 애니메이션
- 오디오 기반 캐릭터 퍼포먼스
Strengths
- 자연스럽고 프레임 단위로 정확한 타이밍의 업계 최고 수준 OmniHuman 립싱크
- 오디오만으로 풍부한 표정, 눈 깜빡임, 고갯짓 구현
- v1.5는 일러스트, 스타일화된 이미지, 정면이 아닌 인물 사진까지 지원
- 업로드한 어떤 얼굴이든 애니메이션 가능 — 고정된 아바타 라이브러리 불필요
- TTS 모델과 매끄럽게 연결해 말하는 얼굴 영상을 처음부터 끝까지 제작 가능
Limitations
- 오디오 입력 필수 — 텍스트-투-비디오 모드 없음
- 선명하고 조명이 좋은 정면 인물 사진에서 가장 좋은 결과
- 1인 인물에 특화되어 있어 여러 명이 등장하는 장면에는 부적합
Tips & Best Practices
Use OmniHuman on Astorie
Connect OmniHuman with other AI models on Astorie's infinite canvas. No GPU required — start free.
Get Started FreeFrequently Asked Questions
OmniHuman은 무엇이고 누가 만들었나요?
OmniHuman은 TikTok과 CapCut을 만든 ByteDance가 개발한 오디오 기반 인물 사진 애니메이션 모델입니다. 정지된 사진 한 장과 오디오 트랙을 입력받아 동기화된 입 모양, 표정, 고갯짓을 담은 말하는 얼굴 영상을 생성합니다. Astorie에서는 로컬 설치나 GPU 없이 OmniHuman v1과 v1.5를 캔버스에서 바로 실행할 수 있습니다.
OmniHuman은 ByteDance가 만든 모델인가요?
네. OmniHuman은 ByteDance가 만들었으며, Intelligent Creation 팀이 개발해 2025년 초 처음 공개되었습니다. OmniHuman AI 패밀리(v1, OmniHuman-1.5)는 인물 사진 한 장과 음성 오디오를 립싱크된 말하는 얼굴 영상으로 바꾸는 데 집중하며, Astorie는 두 버전 모두를 다른 50여 개의 AI 비디오·오디오 모델과 함께 제공합니다.
OmniHuman은 립싱크를 지원하나요?
네, 립싱크는 OmniHuman의 핵심 기능입니다. 입력된 오디오 파형을 읽어 프레임 단위로 정확한 입 모양, 눈 깜빡임, 고갯짓을 만들어내기 때문에 인물 사진이 실제로 말하는 것처럼 보입니다. v1.5는 립싱크 정확도를 한층 더 높였고, v1이 잘 처리하지 못하는 일러스트나 스타일화된 얼굴도 지원합니다.
OmniHuman은 어떤 입력이 필요한가요?
OmniHuman에는 두 가지 입력이 필요합니다. 인물 이미지 한 장(선명하고 조명이 좋은 정면 사진이 가장 좋습니다)과 음성, 내레이션, 노래 같은 오디오 트랙입니다. 텍스트-투-비디오 모드는 없으며, 오디오가 퍼포먼스 전체를 이끕니다. Astorie에서는 먼저 텍스트-투-스피치 모델로 오디오를 생성한 다음 바로 OmniHuman 노드에 연결할 수 있습니다.
OmniHuman은 Kling AI Avatar와 어떻게 다른가요?
OmniHuman과 Kling AI Avatar 모두 인물 사진과 오디오를 말하는 얼굴로 바꿔주지만, OmniHuman은 업로드한 어떤 얼굴에서든 순수한 립싱크 완성도를 뽑아내도록 설계된 반면, Kling AI Avatar는 실감 나는 발표자에 맞춰 조정된 Standard와 Pro 품질 티어를 제공합니다. Astorie에서는 굳이 하나를 고르지 않아도 됩니다 — 팬아웃 기능으로 같은 오디오를 OmniHuman, Kling AI Avatar, Hailuo에서 동시에 실행하고 가장 좋은 결과물만 남길 수 있습니다.
OmniHuman으로 사진 한 장에서 말하는 얼굴 영상을 만들 수 있나요?
네. 정면 인물 사진을 업로드하고 보이스오버를 직접 준비하거나 생성하면, OmniHuman이 립싱크와 자연스러운 고갯짓을 갖춘 말하는 얼굴 영상으로 애니메이션해 줍니다. 그래서 가상 발표자, 콘텐츠 크리에이터 아바타, 팟캐스트 시각화, 내레이션 영상에 이상적입니다. Astorie에서 텍스트-투-스피치 노드와 결합하면 텍스트 → 음성 → 말하는 얼굴로 이어지는 전체 파이프라인을 완성할 수 있습니다.
Astorie에서 OmniHuman은 비용이 얼마나 드나요?
OmniHuman은 Astorie의 크레딧 시스템으로 작동하므로, 모델별로 별도 구독을 하는 대신 구독 할당량이나 지갑 충전 크레딧에서 생성할 때마다 비용을 지불합니다. 2026년 기준으로, 하나의 캔버스에서 같은 오디오를 OmniHuman v1, OmniHuman-1.5, 그리고 경쟁 아바타 모델들에 동시에 실행해 보고 최종적으로 사용할 결과물만 신경 쓰면 됩니다.