
ByteDance
OmniHuman
OmniHumanは、ByteDanceによる音声駆動のリップシンクモデルです。1枚のポートレート写真と音声トラックを入力するだけで、フレーム単位で正確な口の動き・表情・自然な頭の動きを持つトーキングヘッド動画を生成します。ByteDance Intelligent Creationが開発したOmniHuman AIファミリー(v1およびv1.5)は、2026年時点でAstorieが提供するリップシンク動画モデルの中でも特に高精度なモデルの一つです。
OmniHumanは、1枚の写真と音声トラックからリップシンクされたトーキングヘッド動画を生成する、ByteDanceの音声駆動ポートレートアニメーションモデルです。ByteDance OmniHumanは演技全体を作り込みます――音声波形を読み取り、同期した口の動き・まばたき・微表情・頭の揺れを生成することで、被写体が本当にその言葉を話しているように見せます。バージョン1.0は、正面を向いたポートレート写真と音声を組み合わせて、安定したOmniHumanのリップシンクと頭の動きを実現します。バージョン1.5(OmniHuman-1.5)はリップシンクの精度をさらに高め、イラストやスタイライズされた顔を含むより幅広いポートレートのスタイルに対応し、より自然な頭の動きと、より長く安定したテイクを生成します。Astorie上ではどちらのバージョンもテキスト読み上げモデルと同じノードベースのキャンバス上にあるため、テキスト→音声→OmniHumanアニメーションという流れをブラウザから出ることなくエンドツーエンドで実行できます。Kling AI AvatarやHeyGenのようなアバターツールと比べ、OmniHumanは決まったアバターライブラリに頼るのではなく、1枚の画像からの純粋なリップシンク精度に特化して作られており、任意の顔をしゃべらせたいときの第一候補になります。ファンアウト機能を使えば、同じ音声をOmniHuman・Kling AI Avatar・Hailuo Speech-02に同時に流し込み、最も良いテイクだけをバージョントレイに残すことができます。
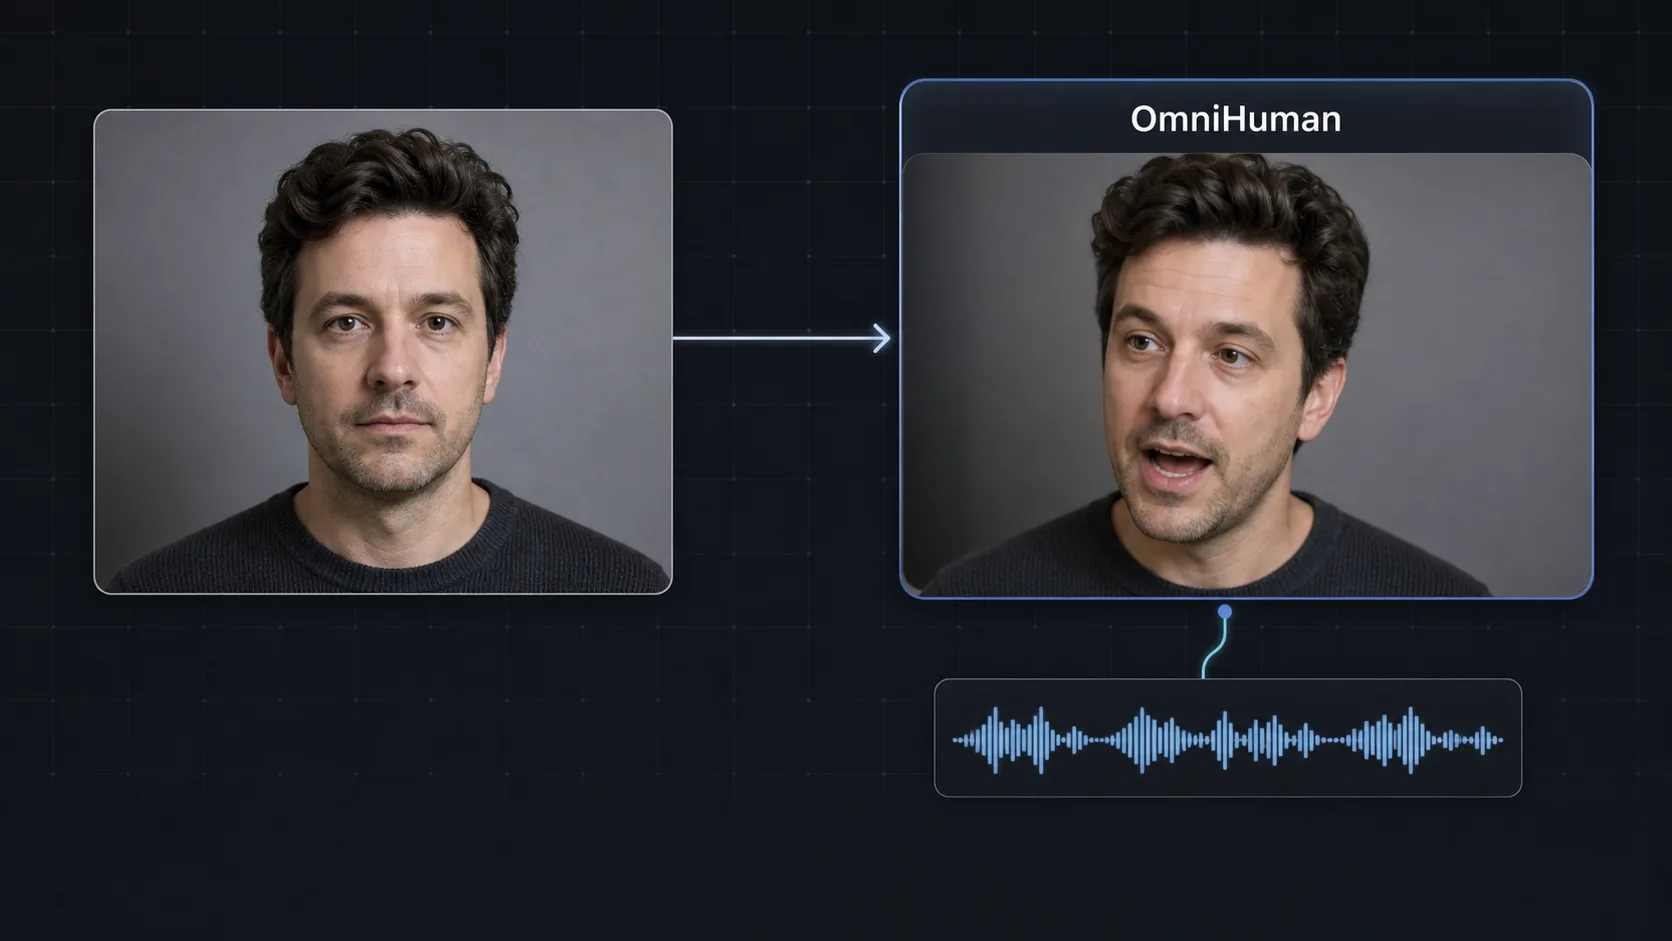
OmniHuman Variants
| Variant | Description |
|---|---|
| OmniHuman v1 | リップシンク・表情・頭の動きに対応した、音声駆動のポートレートアニメーションです。 |
| OmniHuman v1.5 | リップシンクの精度が向上し、多様なポートレートスタイルへの対応力も高まったバージョンです。 |
Capabilities
Supported Aspect Ratios
Best For
- トーキングヘッド動画とバーチャルプレゼンター
- 任意のポートレートをナレーションや歌にリップシンクさせる
- ポッドキャストやナレーションのビジュアライゼーション
- コンテンツクリエイター向けアバターアニメーション
- 音声駆動によるキャラクターの演技表現
Strengths
- 自然でフレーム単位に正確なタイミングを持つ、クラス最高水準のOmniHumanリップシンク
- 音声だけから豊かな表情・まばたき・頭の動きを生成
- v1.5はイラストやスタイライズされた顔、正面以外のポートレートにも対応
- 決まったアバターライブラリ不要で、アップロードした任意の顔をアニメーション化
- TTSモデルとシームレスに連携し、エンドツーエンドのトーキングヘッド動画制作を実現
Limitations
- 音声入力が必須――テキストから動画生成のモードはなし
- 鮮明で光量が十分な正面ポートレートで最良の結果が得られる
- 1人の人物に特化しており、複数人のシーンには不向き
Tips & Best Practices
Use OmniHuman on Astorie
Connect OmniHuman with other AI models on Astorie's infinite canvas. No GPU required — start free.
Get Started FreeFrequently Asked Questions
OmniHumanとは何ですか?誰が開発しましたか?
OmniHumanは、TikTokやCapCutを手がけるByteDanceが開発した、音声駆動のポートレートアニメーションモデルです。1枚の静止写真と音声トラックから、同期した口の動き・表情・頭の動きを持つトーキングヘッド動画を生成します。Astorie上では、ローカルへのインストールやGPUを用意することなく、OmniHuman v1とv1.5をキャンバス上で直接実行できます。
OmniHumanはByteDanceのものですか?
はい。OmniHumanはByteDanceが開発し、同社のIntelligent Creationチームによって2025年初頭に初めて発表されました。OmniHuman AIファミリー(v1とOmniHuman-1.5)は、1枚のポートレート画像と音声から、リップシンクされたトーキングヘッド動画を作ることに主眼を置いており、Astorieでは両バージョンを、他50以上のAI動画・音声モデルとあわせて提供しています。
OmniHumanはリップシンクに対応していますか?
対応しています――リップシンクはOmniHumanの中核機能です。入力された音声波形を読み取り、フレーム単位で正確な口の動き・まばたき・頭の動きを生成することで、ポートレートが本当に話しているように見せます。v1.5ではリップシンクの精度がさらに向上し、v1が苦手としていたイラスト調・スタイライズされた顔にも対応しています。
OmniHumanにはどのような入力が必要ですか?
OmniHumanには2つの入力が必要です。1つはポートレート画像(鮮明で光量が十分な正面写真が最適)、もう1つは音声やナレーション、歌などの音声トラックです。テキストから動画生成のモードはなく、演技全体は音声によって作られます。Astorie上では、まずテキスト読み上げモデルでその音声を生成し、そのままOmniHumanノードに接続できます。
OmniHumanはKling AI Avatarとどう違いますか?
OmniHumanとKling AI Avatarはどちらもポートレートと音声からトーキングヘッドを生成しますが、OmniHumanはアップロードされた任意の顔からの純粋なリップシンク精度に特化して作られているのに対し、Kling AI Avatarはよりリアルなプレゼンター向けに調整されたStandardとProの品質グレードを備えています。Astorieではどちらか一方を選ぶ必要はなく、ファンアウト機能で同じ音声をOmniHuman・Kling AI Avatar・Hailuoに同時に流し込み、最も良いテイクを残せます。
OmniHumanを使って写真からトーキングヘッド動画を作れますか?
作れます。正面向きのポートレートをアップロードし、ナレーションを用意または生成すれば、OmniHumanがその顔を、口の動きが同期し頭も自然に動くトーキングヘッド動画としてアニメーション化します。バーチャルプレゼンターやコンテンツクリエイターのアバター、ポッドキャストのビジュアライゼーション、ナレーションなどに最適です。Astorie上でテキスト読み上げノードと組み合わせれば、テキスト→音声→トーキングヘッドという一連の流れを完結できます。
AstorieでOmniHumanを使うといくらかかりますか?
OmniHumanはAstorieのクレジットシステム上で動作するため、モデルごとに別々のサブスクリプションを契約するのではなく、サブスクリプション枠またはウォレット残高から生成のたびにクレジットが差し引かれます。2026年時点では、同じ音声を1つのキャンバス上でOmniHuman v1・OmniHuman-1.5や他社のアバターモデルに同時に流し込み、実際に採用するテイクだけを気にすればよい、という使い方ができます。